数据清洗自动化:让数据质量从"玄学"变成"可控"
"这份报表的数据逻辑不对,你再核实一下。"当运营主管第三次把数据打回来重做的时候,市场部的实习生小张终于忍不住问了句:"可是数据来源就长这样,我能怎么办?"这大概是每个和数据打过交道的人,都听过的经典对话。数据清洗这件事,长期以来被当成"dirty work"——脏活累活,谁都嫌弃,但谁都绕不开。
但真正让人头疼的,不是清洗本身有多难,而是它太容易出错。格式不统一、缺失值乱填、重复记录判断靠肉眼……一套数据从采集到能用的转化率,行业里有个不太好听的平均值:超过40%的数据分析时间,被消耗在数据清洗环节。更扎心的是,花了时间洗出来的数据,质量还不一定稳。
问题到底出在哪?是数据源不可控,还是清洗方法不够聪明?今天我们就来认真聊聊,数据清洗自动化这件事,到底能不能从根本上解决数据质量的"玄学困境"。
一、数据质量的问题,从来不只是技术问题
很多人以为数据质量差,是因为数据源太烂。但实际上,更普遍的原因是数据清洗流程缺乏标准化——每次遇到问题,靠经验临时处理;不同人处理同一批数据,结果可能完全不一样。
来看一个真实场景:某电商公司需要整合来自淘宝、京东、拼多多三个平台的订单数据。
- 淘宝的订单编号是"T20240315001",京东是"JD-240315-001",拼多多直接是纯数字"20240315001"
- 收货地址字段,淘宝有省市区三级,京东只有省市两级,拼多多用户经常填简称
- 商品名称更是五花八门,同一款iphone手机,可能写成"Apple iPhone 15"、"苹果15手机"、"iphone15 256G"……
面对这种情况,传统做法是让数据分析师写一堆正则表达式、做字段映射。但问题是,平台规则会变,商品名称会变,人的填写习惯也会变。今天写的清洗规则,下个月可能就不管用了。
这就是为什么"数据清洗"容易变成一个持续消耗团队精力的无底洞——不是清洗不了,而是清洗的规则永远跟不上业务变化的速度。
二、自动化清洗的核心:让规则"学会进化"
传统数据清洗最大的局限,在于它是一个静态规则驱动的过程。你定义规则,机器执行规则,一旦数据形态变了,规则就失效。
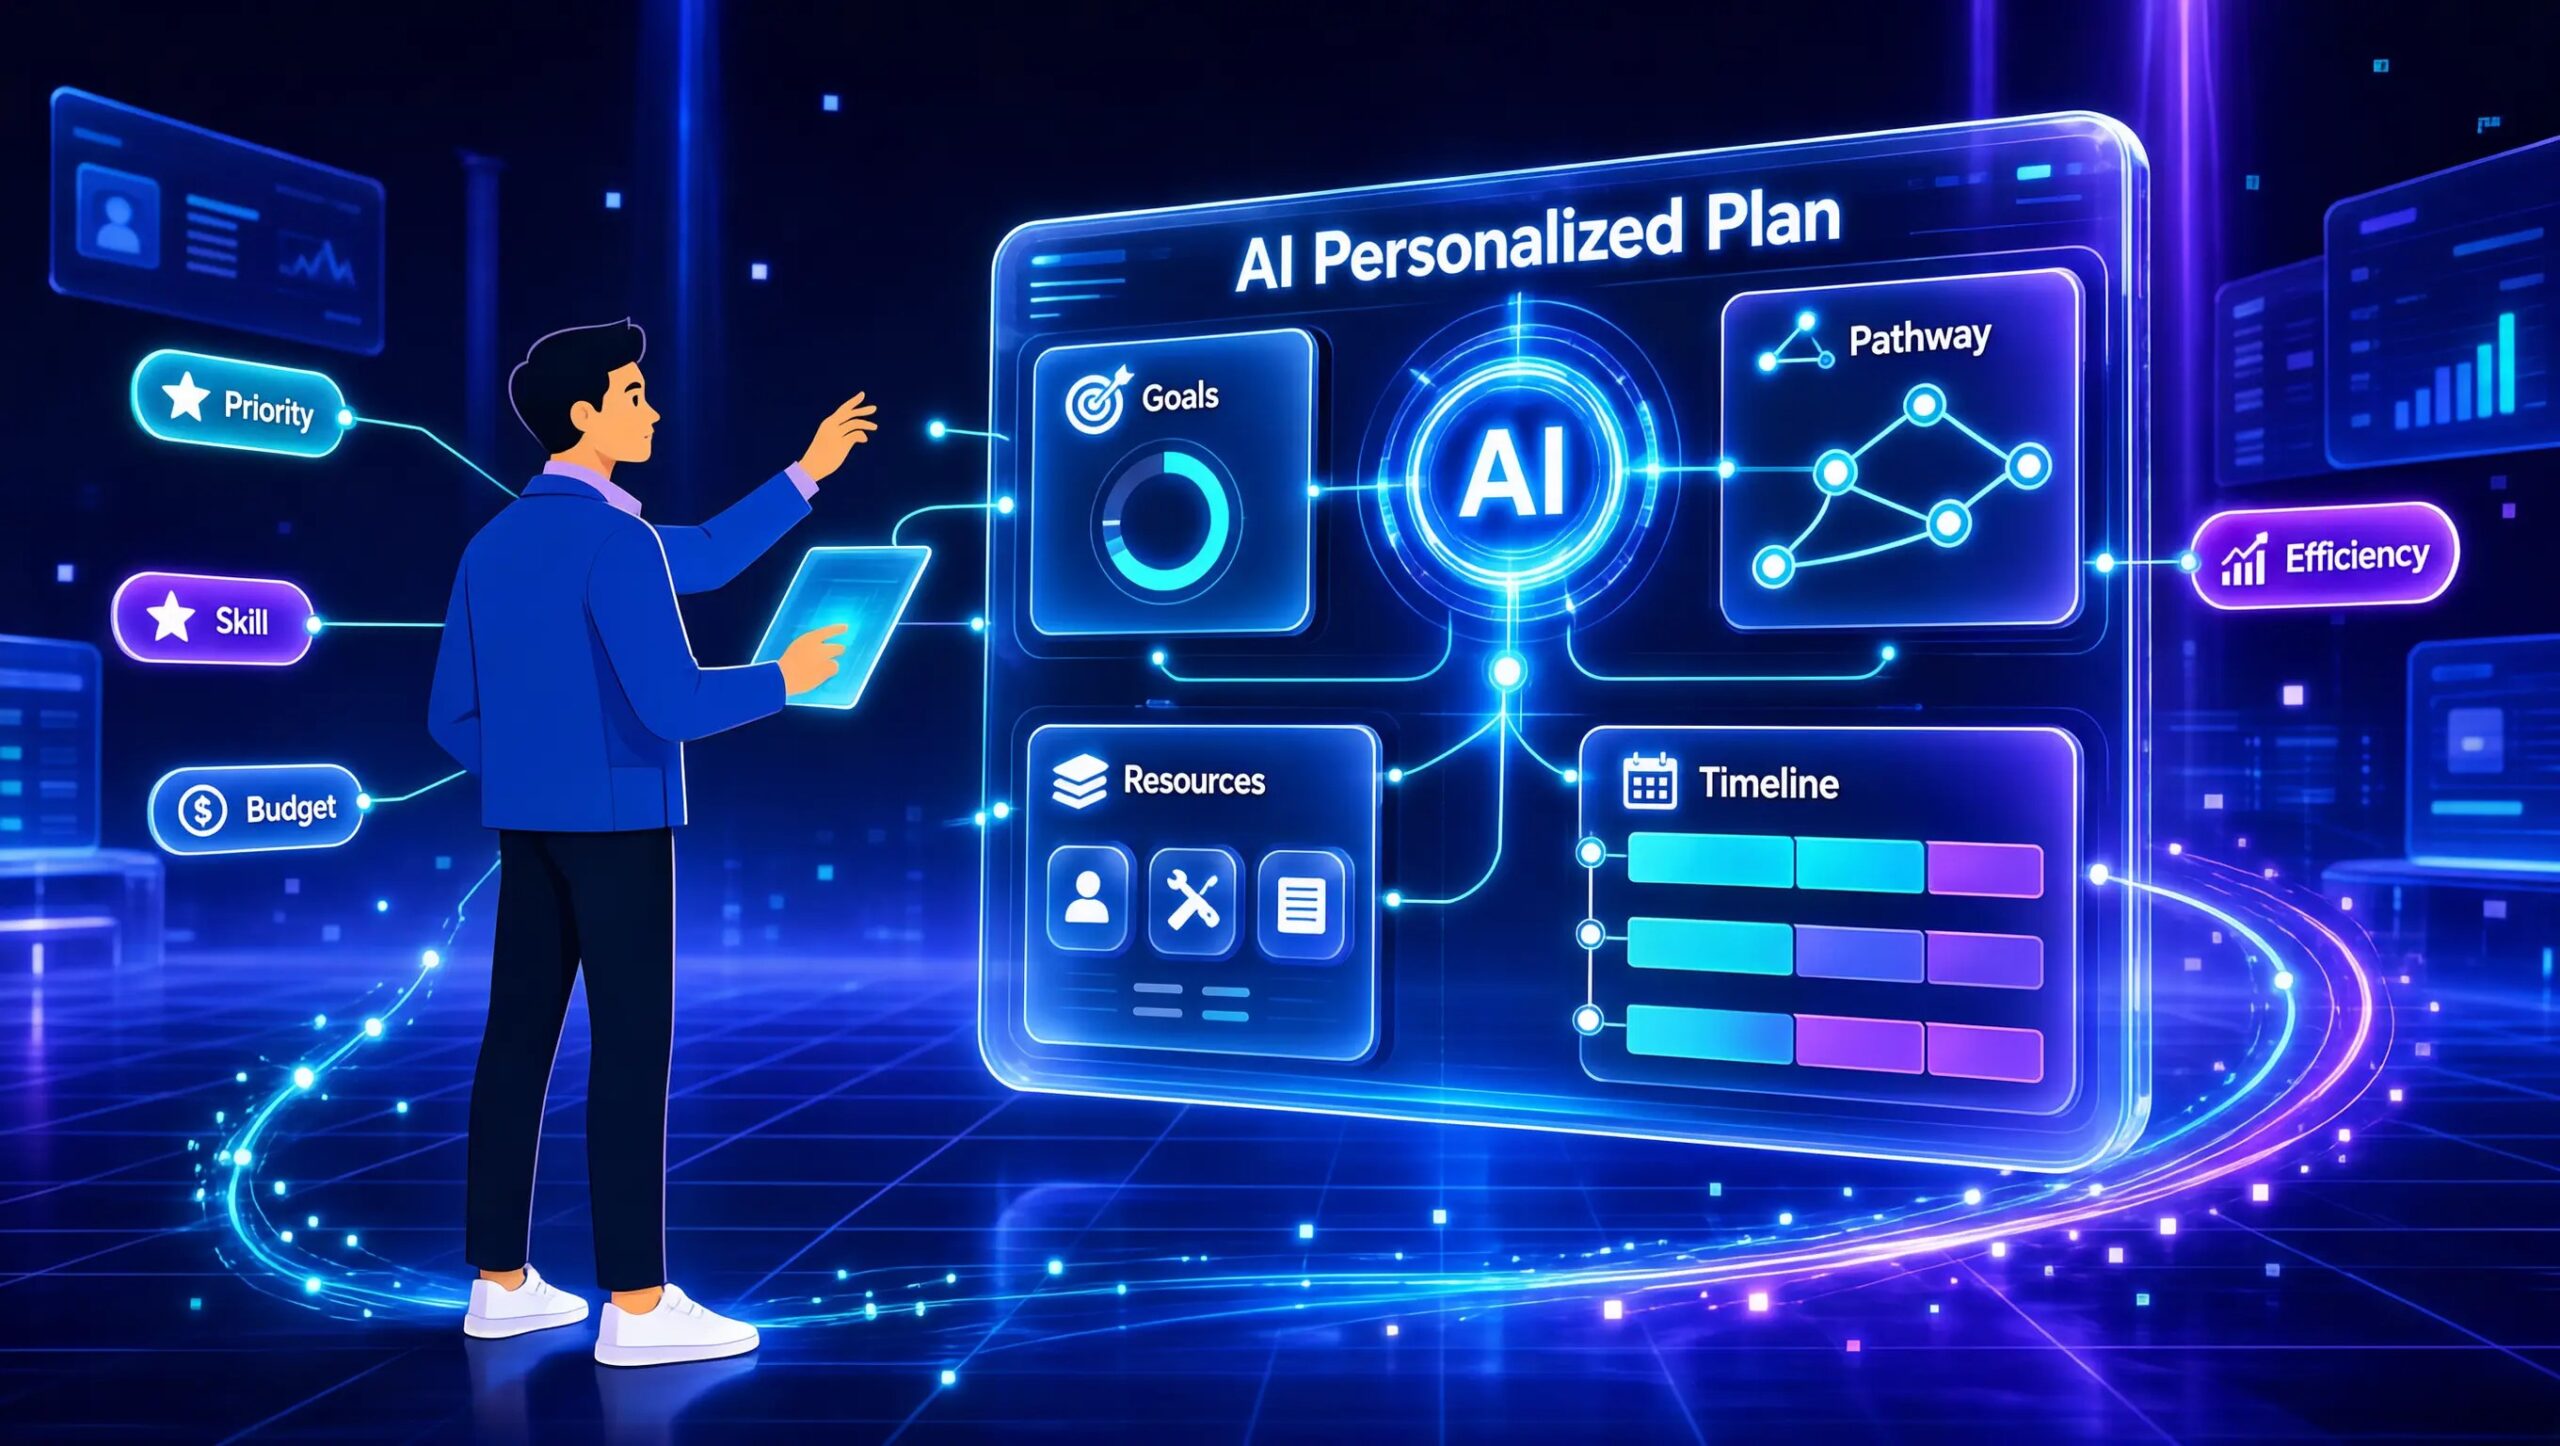
而真正的数据清洗自动化,需要的是一套能够"理解"数据语义的智能系统——不是简单做字符串替换,而是能识别数据背后的业务含义,自动推断正确的处理方式。
1. 智能格式识别与统一
这是最基础但也最容易出错的环节。好的自动化清洗系统,应该能自动识别数据字段的类型和格式,而不是要求用户手动指定。
比如日期字段,系统能自动识别"2024/03/15"、"2024年3月15日"、"03-15-2024"、"Mar 15, 2024"这些不同写法,然后统一转换为标准格式。整个过程不需要人工定义正则表达式,系统会根据上下文语义自动判断。
更关键的是,这种识别能力会随着处理数据的增多而持续学习和优化。当你处理过一批"iphone15"的数据,下次再遇到"iPhone15"、"苹果15",系统会直接套用已有的处理经验,而不需要重新"训练"。
2. 缺失值智能处理
缺失值处理是数据清洗中最考验"经验"的环节。很多人一看到空白字段就选择删除,但如果缺失比例不高、且缺失不是系统性的,随意删除反而会丢失重要信息。
自动化的处理逻辑应该是:先判断缺失原因,再决定处理策略。
- 如果是随机缺失,可用均值/中位数填充
- 如果存在关联性(比如某地区用户普遍缺失手机号字段),则通过其他相关字段推断
- 如果是关键字段缺失,需要标记并提示人工介入
这套逻辑的难点在于:不同业务场景下,"可接受的缺失"标准完全不同。自动化系统需要能够根据业务上下文自适应调整策略,而不是套用一套通用规则走天下。
3. 重复记录精准识别
"明明是同一个客户,为什么出现了三次?"重复记录的识别,听起来简单,做起来却很容易踩坑。
简单的字段匹配(比如姓名相同就判定为重复)往往会误杀——中国同名同姓的人太多了。更靠谱的做法是多字段加权匹配:姓名+手机号+地址+购买记录,综合打分判断。
但这里又有一个现实问题:数据录入时往往存在格式差异。"北京市朝阳区"和"北京朝阳区"算不算同一个地址?"138-1234-5678"和"13812345678"是不是同一个号码?自动化系统需要能够处理这些"模糊匹配"场景,给出相似度评分,而不是简单的"是/否"二元判断。
三、实战指南:如何用AI助手完成一次完整的数据清洗
说了这么多原理,来点实际的。下面以小浣熊AI助手为例,演示一个典型的数据清洗工作流。
场景设定
某教育培训机构,需要整合线下地推、线上表单、第三方渠道三个获客来源的数据,统一导入CRM系统进行客户分析。原始数据存在以下问题:
- 姓名/电话格式不统一
- 渠道来源字段标注混乱("线下地推"vs"地推"vs"线下")
- 存在10%左右的缺失值
- 初步排查疑似重复记录约5%
第一步:导入数据,让AI"先看看"
将原始Excel/CSV文件直接拖入小浣熊AI助手,数据解析完成后,系统会自动给出数据质量报告:字段类型分布、缺失值比例、异常值检测结果一目了然。
这份报告的价值在于:它让你在动手清洗之前,就对"战场"有一个全局认知。哪些字段问题最多、哪些记录需要重点关注,清清楚楚。
第二步:描述需求,自然语言驱动清洗
这是AI助手与传统工具最大的区别——你不需要写SQL、不需要敲代码,直接用自然语言描述你的需求。
比如:"统一姓名和电话的格式,电话号保持11位纯数字,姓名去除空格"。"将渠道来源映射为标准分类:线下地推对应'地推'、线上表单对应'官网'、第三方渠道对应'渠道'"。"对于手机号字段的缺失值,如果地址完整则通过地区号推断,否则标记为待核实"。
小浣熊AI助手会理解你的意图,生成对应的清洗规则,并在执行前预览处理结果。你可以确认无误后再正式执行,也可以调整细节重新生成。整个过程是"说人话、办人事",不需要和数据代码打交道。
第三步:处理重复,系统帮你"去重"但不误杀
重复记录的处理往往最敏感——漏删会让统计失真,误删则可能损失真实客户。
AI助手的做法是:先让模型智能打分,将所有疑似重复的记录按相似度排序,然后优先处理高置信度的重复(比如姓名+电话完全一致的),而对于低置信度的模糊匹配(比如姓名相同但电话不同),则标记出来交由人工判断。
这种"自动化+人工复核"的模式,既保证了效率,又守住了准确率底线。
第四步:导出清洗结果,附带质量证书
清洗完成后,系统会生成一份数据清洗报告,包含:处理记录(哪些规则被执行了)、处理结果统计(删除了多少条、修改了多少条、标记了多少条)、剩余问题说明(有哪些字段仍存在异常)。
这份报告的作用是双重的:对内,它是数据处理的完整审计日志,方便追溯和复盘;对外,当业务方质疑数据质量时,你可以拿出报告说"这批数据的清洗规则是这样的,处理结果是可信的"。
四、为什么说"自动清洗+人工审核"才是最优解
现在市面上有一些号称"全自动"的数据清洗工具,号称不用人工介入就能搞定一切。这种承诺听起来美好,但实际落地时往往问题百出。
原因很简单:数据质量从来没有绝对标准,它本质上是一个业务判断问题。
比如:一条客户记录,电话号码填错了,但地址和姓名都对,这算"有效记录"还是"无效记录"?如果你的业务是需要电话触达,这条记录的价值就大打折扣;但如果你的业务是邮寄教材,那地址正确就够了。
再比如:两个客户的姓名完全一致,但手机号不同,他们是不是同一个人?如果是个人客户,大概率不是;但如果是一个公司的两个联系人,那姓名相同反而是正常现象。
这些判断,AI再聪明也很难完全替代人的业务理解。因此,真正实用的数据清洗自动化,应该是"AI做能做的,人做需要判断的"——AI负责处理规则清晰、逻辑明确的部分,而把真正需要业务理解的决策,交回给懂业务的人。
五、让数据质量成为"可复用的资产"
回到文章开头的问题:数据清洗能不能从"脏活累活"变成"可控流程"?
很多团队的数据清洗之所以反复消耗精力,根本原因在于"经验没有沉淀"——A同事踩过的坑,B同事不知道,下次遇到还是从头摸索。而一套好的数据清洗自动化系统,应该能够记录每一次清洗的规则和决策逻辑,形成可复用的清洗模板。
下次遇到同类型的数据源,直接调用已有模板,AI会自动适配字段、套用规则、给出清洗结果。新数据来了不用从头来过,清洗好的数据质量稳定可追溯,这才是自动化真正的价值所在。
当你的团队不再为"这份数据能不能用"反复扯皮,当业务方拿到清洗好的数据可以直接上手分析,你会发现——数据质量这件事,从来不需要靠运气。
它只需要一套好用的工具,加上一点点把事情做规范的方法论。