小浣熊让跨部门数据整合从不可能变成一键搞定
每个月初,都是企业数据管理者最头疼的时刻。销售部发来一份 Excel,运营部发来一份 CSV,财务部发来一份 PDF,客服部发来一份在线报表文档——四份数据格式各异、字段命名不同、时间周期不一致,却要被整合成一份统一的经营分析报告。过去,这可能意味着数据分析师连续熬上两三个通宵,用 VLOOKUP 匹配到眼睛发酸,才能勉强拼凑出一份勉强可用的汇总表。但如今,小浣熊AI助手正在重新定义跨部门数据整合的效率标准——从“不可能完成的任务”到“一键搞定”,这道鸿沟,正在被 AI 技术填平。
为什么跨部门数据整合总是“老大难”?
在深入了解解决方案之前,我们需要先看清问题的本质。跨部门数据整合之所以让无数职场人头疼,并非单一原因所致,而是多个痛点叠加形成的系统性挑战。
数据孤岛:部门之间的“数字柏林墙”
现代企业中,每个部门几乎都建立了自己独立的数据管理系统。销售团队使用 CRM 系统记录客户数据,财务部门依赖 ERP 系统处理账务,市场部门可能在使用独立的营销自动化平台,而客服部门的工单数据又分散在另一个系统里。这种分散化的数据存储模式,本质上是企业信息化建设逐步推进的副产物——每次新系统上线,都是为了解决特定部门的特定需求,却很少从企业全局视角规划数据互通。当需要做一份跨部门的经营分析报告时,数据分析师往往发现自己面对的不是一份完整的数据集,而是十几个互不相连的“数据孤岛”。
格式混乱:Excel、CSV、PDF、JSON大乱斗
即使最终拿到各部门的数据文件,格式不统一又成了新的拦路虎。有的部门导出的是 .xlsx 格式的 Excel 文件,有的可能只提供 .csv 文本文件,财务数据出于安全性考虑可能只愿意分享 PDF 格式的报表,而某些系统只能导出 JSON 或 XML 这种程序员才能看懂的格式。对于非技术背景的业务人员来说,仅是搞清楚这些格式之间的区别和转换方法,就足以消耗大量时间。更糟糕的是,不同格式的数据往往需要不同的处理工具,一个完整的数据整合流程可能要在 Excel、Python、数据库之间来回切换。
字段歧义:同名不同义、同义不同名
即使数据格式统一了,字段命名的差异仍然会让数据整合功亏一篑。销售部把客户编号叫做“Customer_ID”,市场部叫它“ClientCode”,财务部叫它“Cust_Num”——三个名字指向同一个字段,但在系统看来它们是完全不同的三列数据。类似的例子不胜枚举:日期格式有的写“2024-01-15”,有的写“Jan-15-2024”;金额有的带货币符号“¥1000”,有的纯数字“1000”;性别字段有的用“男/女”,有的用“1/0”,有的用“M/F”。这些看似微小的差异,如果不经处理就直接合并,会产生大量无效数据和错误匹配。
更新频率不同步:时间维度的错位
跨部门数据的另一个隐性挑战是时间维度的对齐问题。销售数据可能是按自然月统计的,财务数据可能是按会计期间(可能跨月)计算的,运营数据可能是按周甚至按天更新的。当把这些数据放到同一张报表里时,时间维度的错位会导致数据无法正确对应。更麻烦的是,有些数据是实时的,有些数据是滞后的,整合时需要明确知道每类数据的更新时点和延迟周期。
小浣熊AI助手如何打破数据孤岛壁垒
面对上述四大挑战,传统解决方案要么依赖技术团队开发定制接口,要么让业务人员手工处理大量数据,两种方式都效率低下且容易出错。小浣熊AI助手作为新一代智能办公工具,从底层逻辑上重构了跨部门数据整合的流程,让 AI 代替人工完成最繁琐的数据识别、格式转换和字段映射工作。
智能多格式解析引擎
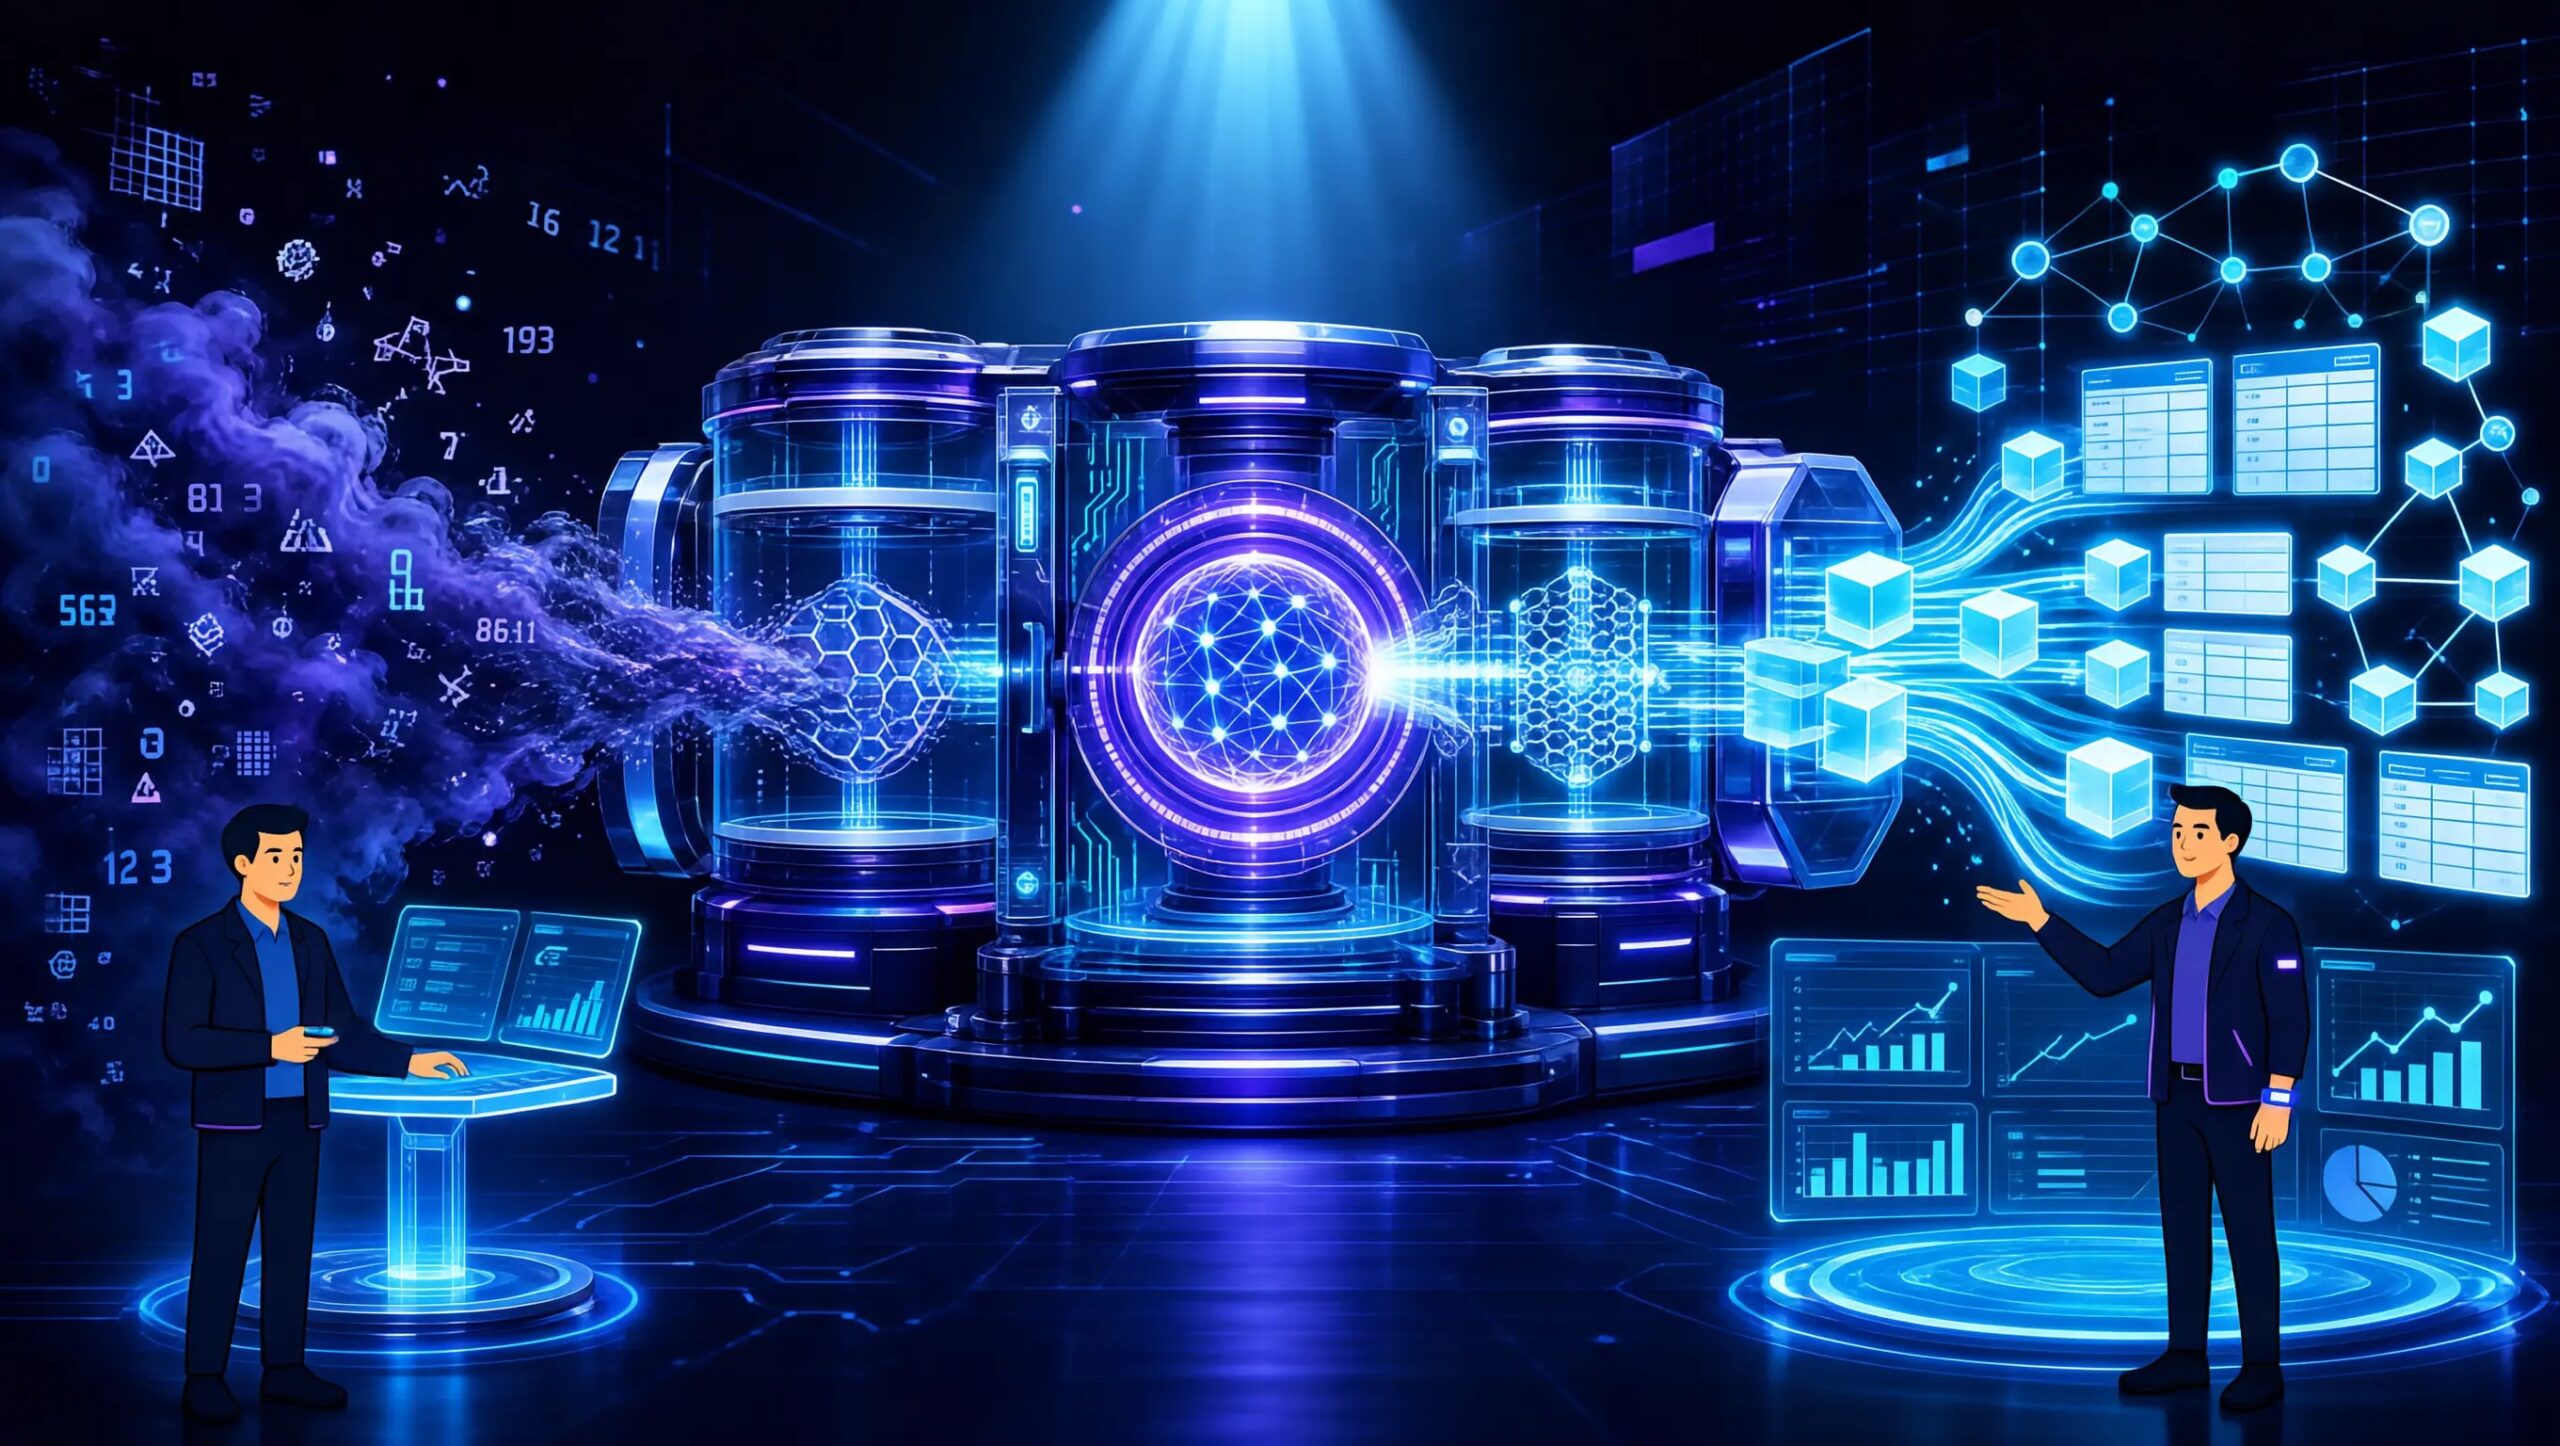
小浣熊AI助手内置了强大的多格式数据解析引擎,能够自动识别并读取 Excel(.xlsx、.xls)、CSV 文本文件、PDF 表格数据、JSON/XML 结构化数据,甚至支持从网页表格和在线文档中提取数据。用户无需关心源文件的格式差异,只需将所有待整合的数据文件统一上传给小浣熊,系统会自动完成格式识别和内容解析。这一步的智能化程度极高——即使是带有合并单元格、多级表头、嵌套结构的复杂 Excel 文件,小浣熊也能准确理解其数据结构,提取出可用的数据区域。
语义级字段智能匹配
这是小浣熊在跨部门数据整合中最核心的能力之一。传统工具进行数据合并时,必须依赖精确的字段名称匹配,如果两个系统的字段命名不同,合并就会失败。小浣熊AI助手则采用了语义理解技术,能够“读懂”字段的实际含义。当它看到“Customer_ID”和“ClientCode”时,会识别出这两个字段虽然在名称上不同,但都指向客户唯一标识符,因此自动将其识别为可以合并的关联字段。同样的语义理解能力也应用在数据内容层面——小浣熊能够识别“男/女”、“1/0”、“M/F”都表示性别,“2024-01-15”和“Jan-15-2024”都表示同一日期,从而自动完成数据标准化转换。
跨源数据自动合并策略
在完成格式解析和字段语义匹配后,小浣熊会基于用户设定的关联条件(如按客户ID合并、按日期对齐、按部门匹配等),自动执行多源数据合并。合并过程中,系统会智能处理重复记录、缺失值和冲突数据,根据预设规则(如“以最新数据为准”、“以权威来源为准”等)进行自动清洗。对于合并后可能产生的数据质量问题(如一对多匹配导致的记录膨胀),小浣熊也会进行提示并提供多种处理方案供用户选择。
实操指南:小浣熊一键整合跨部门数据完整流程
下面我们通过一个具体场景,演示如何使用小浣熊AI助手完成跨部门数据整合。假设公司需要整合销售部、客服部和财务部的数据,生成一份月度客户价值分析报告。
步骤一:批量上传原始数据文件
登录小浣熊AI助手后,进入“数据整合”功能模块。点击“上传数据源”按钮,可以一次性选择多个来自不同部门的数据文件。支持文件类型包括 Excel、CSV、PDF、JSON 等常见格式。这里我们上传三份文件:销售部的客户成交数据(Excel)、客服部的客户工单记录(CSV)、财务部的客户回款明细(PDF)。
步骤二:AI 自动识别数据结构和内容
上传完成后,小浣熊会立即开始解析工作。解析过程大约需要几秒钟到几十秒钟(取决于文件大小),期间系统会逐个分析每个数据源的结构特征,包括表头位置、列数、数据类型、数据量等。解析完成后,界面会展示每个数据源的基本信息预览。此时你会看到销售数据包含“客户名称”“成交金额”“成交日期”等字段,客服数据包含“客户名称”“工单类型”“处理时长”等字段,财务数据包含“客户名称”“回款金额”“回款日期”等字段。
步骤三:配置关联条件和合并策略
接下来是关键步骤——配置数据合并规则。小浣熊会根据语义分析结果,自动推荐关联字段。以本场景为例,系统会识别出三个数据源都包含“客户名称”字段,并将其标记为推荐的关联键。用户也可以根据实际需求修改关联条件,比如改为按“客户ID”进行更精确的匹配。
除了关联条件外,用户还需要选择合并策略。小浣熊提供多种合并模式:
- 内连接(Inner Join):只保留三个数据源中都存在的客户记录,适用于需要完整多维度数据的分析场景。
- 左连接(Left Join):以销售数据为基础,匹配客服和财务数据,即使某些客户在客服或财务数据中没有记录也会保留。
- 全外连接(Full Outer Join):保留所有数据源中的记录,用于全面盘点所有客户数据。
步骤四:一键执行合并并预览结果
确认合并规则后,点击“执行合并”按钮,小浣熊会在几秒钟内完成所有数据处理工作。合并完成后,系统会展示结果预览,包含合并后的字段列表、记录总数、数据质量报告等。用户可以查看合并后的数据表格,检验数据是否正确对应。
以本次操作为例,合并后的数据表应该包含“客户名称”“成交金额”“回款金额”“工单总数”“平均处理时长”等来自三个部门的完整字段,每个客户一行记录,所有数据按统一的时间周期对齐。
步骤五:导出或直接生成分析报告
数据整合完成后,用户有多种后续选择。最简单的是直接导出为 Excel 或 CSV 文件,用于进一步分析或制作汇报材料。如果希望一步到位,小浣熊还支持直接基于合并后的数据生成可视化报告——点击“生成分析报告”按钮,AI 会自动识别数据特征,推荐合适的图表类型(如客户价值分布图、回款周期分析图等),并生成配套的文字解读。
典型应用场景:这些情况最适合用小浣熊整合数据
场景一:市场营销与销售业绩联合分析
营销部门投入了大量广告费用获取线索,销售部门负责将这些线索转化为订单,但两边的数据往往各自孤立,无法准确评估营销投入的 ROI。使用小浣熊,可以将市场部的线索数据(来源渠道、获取时间、用户画像)与销售部的成交数据(成交时间、成交金额、客户跟进记录)按客户手机号或邮箱进行关联,生成从线索到成交的全链路转化分析报表,清晰展示每个渠道的投入产出比。
场景二:人力资源与财务的薪酬福利分析
HR 系统记录着每位员工的岗位、职级、入职时间、培训记录,而财务系统记录着工资、奖金、社保公积金等薪酬数据。将两份数据按员工工号关联后,可以分析不同部门、不同职级员工的薪酬结构合理性,识别异常值(如同等岗位薪酬差异过大),为薪酬体系优化提供数据支撑。
场景三:供应链与库存的经营分析
采购部门关注供应商交货及时率,质量部门关注来料合格率,仓储部门关注库存周转率,销售部门关注订单交付满意度——这些看似独立的数据,其实可以通过采购订单号或产品SKU进行关联。小浣熊可以帮助企业将供应链上下游的关键数据整合在一起,建立完整的供应链健康度监控看板。
数据整合质量保障:小浣熊的智能质检机制
数据整合不是简单地把数据放在一起,更重要的是保障整合后的数据质量。小浣熊AI助手内置了完善的数据质量检测机制,会在合并过程中和完成后自动进行多维度检查。
重复记录检测
当两个数据源中存在重复的客户或订单记录时,系统会标记重复项并提示用户选择保留策略——是保留所有记录、只保留最新一条,还是只保留金额最大的一条。
缺失值分析
对于合并后某些字段为空白的记录(可能是源数据本身缺失,也可能是关联匹配失败),小浣熊会统计缺失率并高亮显示缺失严重的字段,帮助用户评估数据完整性。
异常值预警
基于统计学方法,小浣熊会自动识别数值型字段中的异常值(如单笔订单金额远超平均水平、某客户工单数量异常高等),并通过颜色或图标进行标注。用户可以选择查看异常详情,判断是否为数据错误还是真实的业务异常。
关联成功率报告
合并完成后,系统会生成一份关联报告,展示匹配成功的记录数、匹配失败的记录数及失败原因。这份报告可以帮助用户发现数据问题——如果匹配成功率过低,可能是关联字段选择不当或源数据存在质量问题。
进阶技巧:让小浣熊的数据整合更高效
模板复用:一次配置,多次使用
对于定期需要执行的跨部门数据整合任务(如月度经营分析、周度销售汇总),小浣熊支持保存整合模板。用户可以将数据源配置、关联规则、合并策略、质量设置等全部参数保存为模板,下次执行同类任务时只需上传新数据文件,选择对应模板,一键即可完成整合,大幅提升日常工作效率。
定时任务:让数据同步自动化
对于数据来源相对固定的场景,可以设置定时整合任务。例如每周一早上9点自动执行一次跨部门数据合并,将上周的销售、运营、客服数据整合后生成周报文件,并推送到指定的云盘或邮箱。这种自动化机制可以将数据分析师从重复性工作中彻底解放出来。
自定义字段映射规则
虽然小浣熊的语义理解能力很强,但在某些特殊场景下,用户可能希望自定义更精确的字段映射关系。系统提供了可视化映射编辑器,用户可以通过拖拽方式指定源字段与目标字段的对应关系,还可以添加计算字段(如将“成交金额”和“成本”字段合并计算“毛利润”)。
小浣熊数据整合能力与其他工具的核心差异
为了帮助读者更直观地理解小浣熊在跨部门数据整合方面的优势,我们将其与传统方案进行对比:
| 对比维度 | 传统手动整合 | 专业BI工具 | 小浣熊AI助手 |
|---|---|---|---|
| 学习成本 | 低(Excel基础即可) | 高(需专业培训) | 低(自然语言交互) |
| 处理时间 | 数小时至数天 | 数小时 | 数分钟 |
| 格式支持 | 仅支持结构化表格 | 需数据预处理 | 原生支持多格式 |
| 字段匹配 | 完全依赖人工 | 需手动配置映射 | AI语义自动匹配 |
| 数据清洗 | 手工处理,易出错 | 规则配置,较繁琐 | 智能识别自动处理 |
| 重复工作 | 每月重复执行 | 需重建数据管道 | 模板复用 |
总结与行动建议
跨部门数据整合曾经是让无数企业头疼的“不可能任务”,但随着 AI 技术的深入应用,这道难题正在被重新定义。小浣熊AI助手通过智能多格式解析、语义级字段匹配、自动数据清洗和模板化工作流四大核心能力,让跨部门数据整合从过去需要专业技能加大量时间的复杂工程,变成任何业务人员都能轻松完成的一键操作。
对于企业而言,这意味着更高效的决策支持——当管理层需要一份跨部门经营分析报告时,数据团队可以快速响应而非让领导等待数日。对于个人而言,这意味着从繁琐的数据处理工作中解脱出来,将更多精力投入到真正有价值的分析和洞察工作中。如果你也正在为跨部门数据整合而苦恼,不妨尝试让小浣熊来帮你——也许,它真的能把那些你以为“不可能”的事情变成现实。
如果你想第一时间体验小浣熊AI助手的数据整合能力,或者了解如何将这一工具应用到你的具体业务场景中,欢迎直接联系我们的 AI 顾问团队,获取专属的解决方案和免费试用机会。

#小浣熊AI助手 #AI办公 #数据整合 #跨部门协作 #BI数据可视化 #AI数据分析 #办公自动化 #智能数据处理