知识藏在文件夹里等于没有:小浣熊知识库让企业信息一键可查
你有过这样的经历吗?上周明明看过的那份合同条款,现在怎么都翻不到;新同事问起去年Q3的项目方案,文件夹里搜出来的版本七八个,根本不知道哪个是最新版;公司沉淀了五年的经验文档,打开一看全是过时信息,想找的人早就离职了。
这不是你一个人的问题。信息爆炸时代,企业知识管理的困境已经从"找不到"演变成"不敢找"——因为找了也可能是错的。这种困境,正在被AI重新定义。而小浣熊知识库的诞生,或许让这个答案变得简单。
事件:企业知识管理进入"AI时刻"
2024年,商汤科技旗下小浣熊AI助手家族正式推出知识库小浣熊产品,标志着AI知识管理解决方案正式进入企业办公主流赛道。
这不是一次简单的功能更新。从技术底层看,知识库小浣熊整合了商汤自研大模型的语义理解能力、多模态文档解析能力以及智能检索算法,形成了一套完整的"知识获取-知识整理-知识应用"闭环。
根据官方披露,核心能力聚焦在三个方面:跨格式文档智能解析、语义级精准检索、知识图谱构建。对于苦于知识管理多年的企业用户来说,这三个能力的组合,击中的正是最核心的痛点。
困境:为什么企业的知识永远"不在服务区"
让我们先把镜头对准真实的办公场景。
某互联网公司的运营主管林晓(化名)分享过她的日常:每天至少有半小时浪费在"找东西"上。项目文档存在共享盘,但命名规则是2019年定的,之后进来的人各有各的习惯;飞书文档和本地文件散落在不同设备,同事问起来只能说"我记得好像有";最崩溃的是每次做季度汇报,要翻遍七八个文件夹才能拼出一份勉强能用的历史数据。
"公司的知识库就像一个永远在装修的图书馆,"林晓说,"每次以为整理好了,新的内容又塞进来,原来的结构全乱了。"
这种困境背后有三重结构性矛盾:
第一重:信息生产者与使用者的割裂
写报告的人按自己的逻辑命名文件,找报告的人按自己的理解搜索关键词。两个不在同一频道的人之间,永远隔着一道"信息差鸿沟"。
第二重:知识沉淀与知识老化的赛跑
企业知识库的"保鲜期"往往只有18个月。人员流动、业务调整、战略转向,每一项变化都在让存量知识快速贬值。传统文件夹式的知识管理,本质上是在用静态结构应对动态世界。
第三重:搜索能力与信息量的倒挂
当知识库从100份文档增长到10000份,搜索体验往往不是线性变好,而是指数级变差。关键词匹配越来越不准,同名文件越来越多,"搜索结果第一页没有答案"成为常态。
这三重矛盾叠加,构成了企业知识管理的"不可能三角":量大、精准、实时,三个目标传统工具最多同时满足两个。
解法:小浣熊知识库的三把钥匙
那么,小浣熊知识库是如何破解这个困局的?让我们从具体功能层面拆解。
钥匙一:从"文件名搜索"到"语义理解搜索"
传统搜索的本质是"关键词匹配"——你搜"Q3运营报告",系统只认"Q3"和"运营报告"这两个词出现的位置。如果文档标题写的是"第三季度业务复盘",对不起,搜不到。
小浣熊知识库的检索逻辑完全不同。它基于商汤大模型的语义理解能力,能够识别"Q3"和"第三季度"的语义等价性,能够理解"运营报告"和"业务复盘"可能指向同一类内容,甚至能根据上下文推断用户的真实搜索意图。
换句话说,搜索体验从"你输入什么就找什么"升级为"你想找什么就说出来"。
钥匙二:从"单文档解析"到"多源异构整合"
企业知识库的文档格式五花八门:Word报告、Excel数据表、PPT演示文稿、PDF合同扫描件、内部系统导出的数据报表……每种格式的解析逻辑完全不同,传统工具往往只能处理其中1-2种。
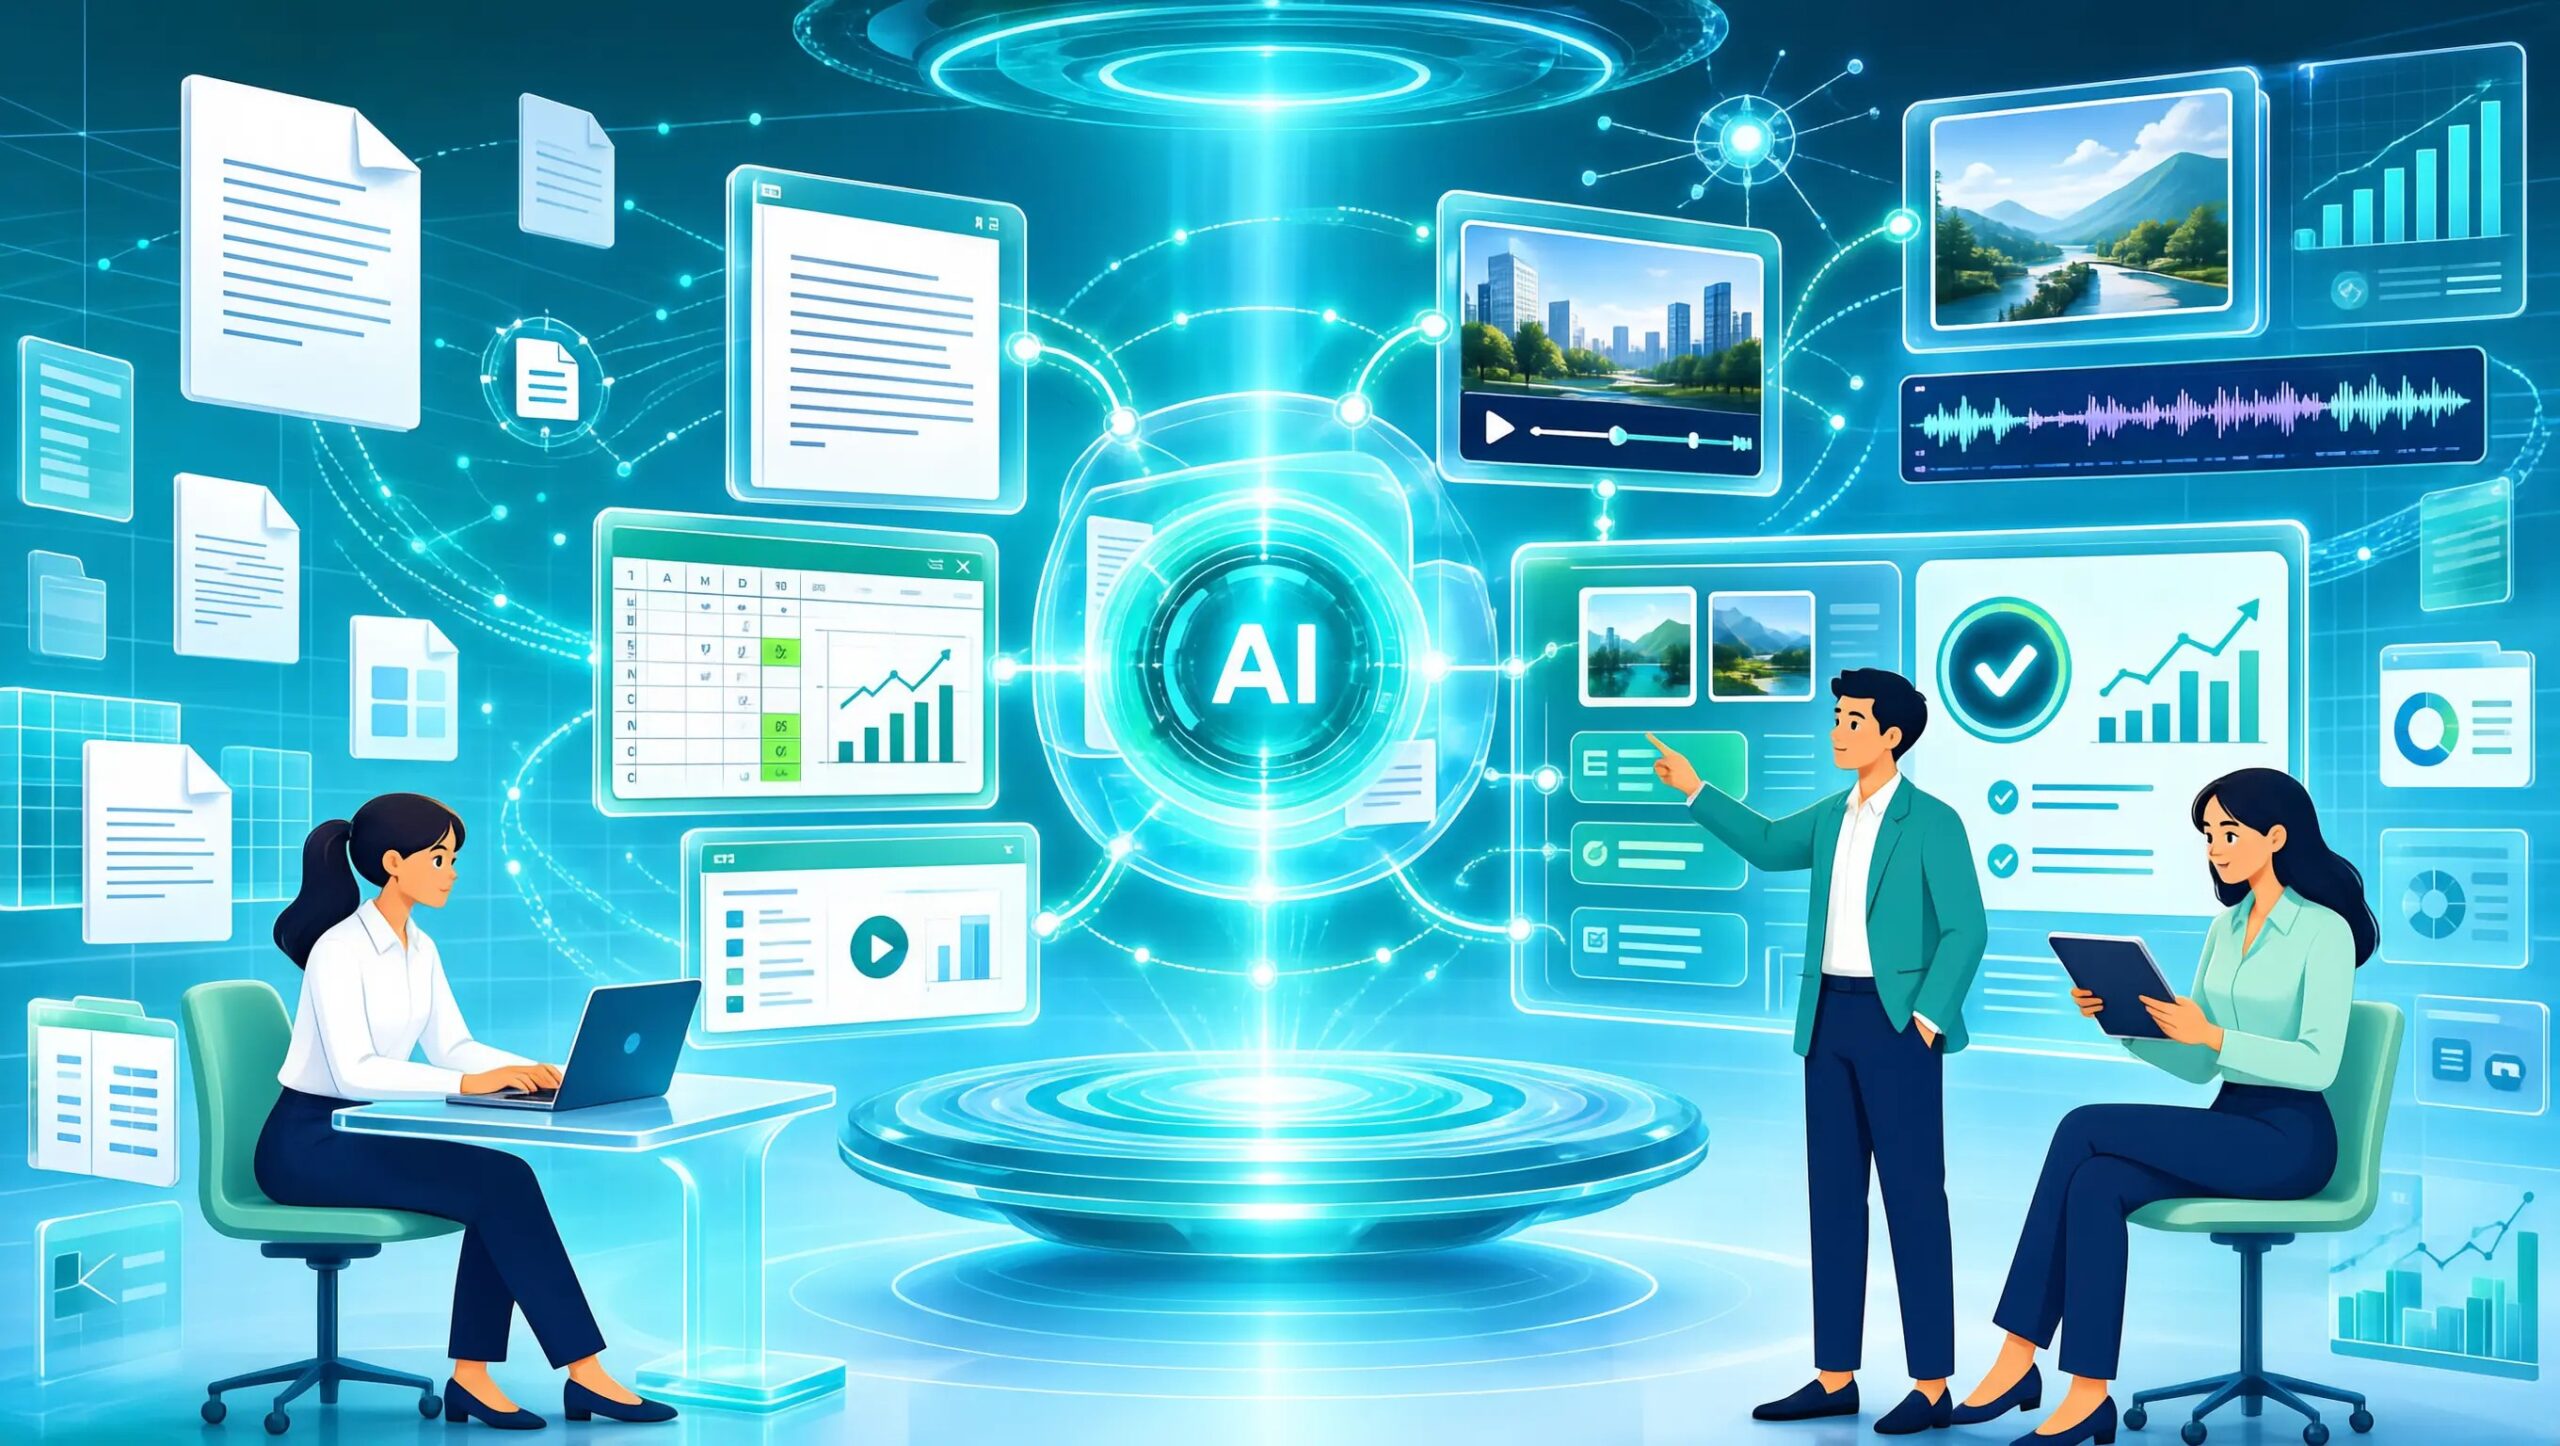
小浣熊知识库的多模态解析能力,覆盖了办公场景中常见的十余种文档格式。更重要的是,它不只是"打开"这些文件,而是能够理解文档内部的结构关系:表格里的数据、图表中的趋势、正文与附录的逻辑关联,都能被提取并纳入知识库索引。
这意味着什么?当你在小浣熊知识库里搜索"去年毛利率最高的客户"时,系统可以跨文档提取Excel中的财务数据和Word报告中的业务分析,自动拼凑出完整答案,而不是让你自己去找两份文件手动对比。
钥匙三:从"文件夹层级"到"知识网络"
传统文件夹的本质是一棵树形结构,每个文件只能归属于一个父节点。但知识的实际关系往往是网状的——一份产品文档可能同时关联市场策略、竞品分析、用户反馈、客服话术等多个维度。
小浣熊知识库支持知识图谱构建能力,能够自动识别文档之间的关联关系,生成可视化的知识网络。当用户进入某个知识点时,系统会自动推荐与之相关的其他内容,帮助用户从"点状搜索"升级为"网状探索"。
这对于新人入职培训、跨部门项目协作、历史经验复用等场景,价值尤为显著。
对比:为什么小浣熊知识库不是"另一个网盘"
市面上不缺云存储产品,从个人级的百度网盘、阿里云盘,到企业级的NAS、协作文档系统,都在扮演"知识仓库"的角色。但仓库和知识库的本质区别在于:仓库只负责存储,知识库负责"理解"和"连接"。
让我们用一张对比表说清楚差异:
| 维度 | 传统网盘/文档库 | 小浣熊知识库 |
|---|---|---|
| 搜索方式 | 文件名关键词匹配 | 语义理解检索 |
| 文档理解 | 只识别文件名和标签 | 解析全文内容与结构 |
| 关联发现 | 需手动查找相关文档 | 自动推荐关联知识网络 |
| 知识更新 | 依赖人工维护目录结构 | 智能识别版本更新与过期 |
| 问答能力 | 无 | 支持基于知识库的智能问答 |
| 多模态支持 | 有限 | 十余种格式深度解析 |
这不是功能多寡的问题,而是底层逻辑的差异。网盘解决的是"文件存哪里"的问题,知识库解决的是"知识怎么用"的问题。对于真正需要盘活企业知识资产的组织来说,选择后者才是正确的起点。
落地:从"工具上线"到"知识飞轮"的跃迁
知识库的价值不是上线第一天就能全部释放的。它需要经历一个"知识飞轮"的建设过程。
在初始阶段,重点是存量知识的数字化——将散落在邮箱、微信、共享盘、本地文件夹里的历史文档统一接入知识库,完成格式转换和基础清洗。
在成长阶段,重点是增量知识的自动化——通过与企业办公系统(OA、IM、项目管理工具)的深度集成,让新产生的文档自动入库、智能分类、实时更新。
在成熟阶段,知识库会形成自生长的知识网络——不同文档之间的关联被持续挖掘,知识图谱越来越丰富,搜索准确率随着使用数据的积累而不断提升,真正成为组织的"智慧大脑"。
某教育科技公司的CTO在内部复盘时分享过他们的经验:"上线知识库三个月后,新产品研发的文档检索时间从平均40分钟降到了8分钟。更重要的是,新入职的工程师现在可以直接向知识库提问'某某功能的历史设计决策是什么',而不是满公司找人问。"
趋势:知识管理正在被AI重新定义
如果我们把视野拉远一点,会发现小浣熊知识库的诞生,实际上顺应了一个更大的行业趋势——企业知识管理正在从"存储时代"进入"智能时代"。

过去二十年的知识管理,核心命题是"如何让信息不丢失"。云存储、版本控制、权限管理、协作编辑,这些技术解决的都是存储和协同问题。
但当企业的信息量从GB级进入TB级,当员工的时间成本成为最稀缺的资源,"存得住"已经不够用了,"找得到、用得上、靠得住"才成为新的刚需。
这正是AI技术的用武之地。大模型在语义理解、多文档关联、长上下文处理方面的能力突破,让"知识可对话"成为可能。而小浣熊知识库的定位,正是把这种能力封装成企业开箱即用的产品。
可以预见,未来3-5年,企业知识库的主流形态将发生根本性转变:从"人工维护的文件夹"到"AI驱动的知识大脑"。谁能更早完成这个跃迁,谁就能在知识复用效率上建立显著竞争优势。

写在最后
知识管理领域有句老话:"信息是昨天的知识,知识是用过的经验。"
但如果我们连"用过的经验"都找不到,那它对于组织的价值就等于零。小浣熊知识库试图解决的问题,本质上不是技术问题,而是认知问题——当一家企业真正意识到知识是需要被"管理"而不是"存放"的,改变就已经开始了。
工具永远在进化,但不变的是那个朴素的逻辑:让正确的信息,在正确的时间,出现在正确的人面前。 这件事,AI正在帮我们做得更好。
如果你所在的企业也在经历"知识溺水"的困扰,不妨先从一次简单的检索体验开始——在小浣熊知识库里,用自然语言问一个问题,看看答案是否超出预期。改变,有时候就从一个提问开始。