小浣熊知识库检索比翻聊天记录快十倍:企业知识管理正在被AI颠覆
在一家典型的互联网公司,新人入职第一天往往会收到一个神秘的文件夹——里面密密麻麻排列着数百个群聊记录截图、版本说明文档、以及各种"前辈留下的"经验帖。这个文件夹有个响亮的名字:知识沉淀。但对于当事人来说,更准确的名字应该是:电子垃圾。因为当真正需要找到某个关键信息时,他们通常会在数十个群聊记录里翻到崩溃。
这正是小浣熊知识库想要解决的问题。商汤科技旗下的这款AI知识管理工具,正在用"整库语义检索"的能力,重新定义什么叫"找东西"——不是关键词匹配,不是文件名搜索,而是真正理解你在问什么。
从"大海捞针"到"精准狙击":知识检索的代际差
要理解小浣熊知识库的价值,首先要承认一个残酷的事实:绝大多数企业的知识管理,实际上处于"有存储无检索"的阶段。
传统检索的三重困境
当你在公司内部资料库搜索"Q3季度报告"时会发生什么?搜索引擎可能返回237个结果,每一个标题都包含Q3、季度、报告这三个关键词,但它们可能分别是Q3版本更新说明、Q3用户反馈汇总、Q3部门述职报告,或者是三年前的老文件。而你需要的那份特定的、包含某关键数据的报告,很可能因为命名不规范,被淹没在第156条结果里。
更糟糕的是,当你试图用口语化问题搜索时——比如"去年双十一服务器为什么会挂"——传统搜索引擎基本处于失效状态。因为没有任何人会把这个关键事件写成标题为"双十一服务器宕机原因分析"的文档,它更可能出现在某次复盘会议的纪要里,或者某位工程师的周报中,甚至只是一条群聊记录。
- 关键词匹配:依赖精确术语,语义无关
- 文件命名:高度主观,标准不统一
- 分类体系:层级深,交叉检索弱
小浣熊知识库的三个核心能力
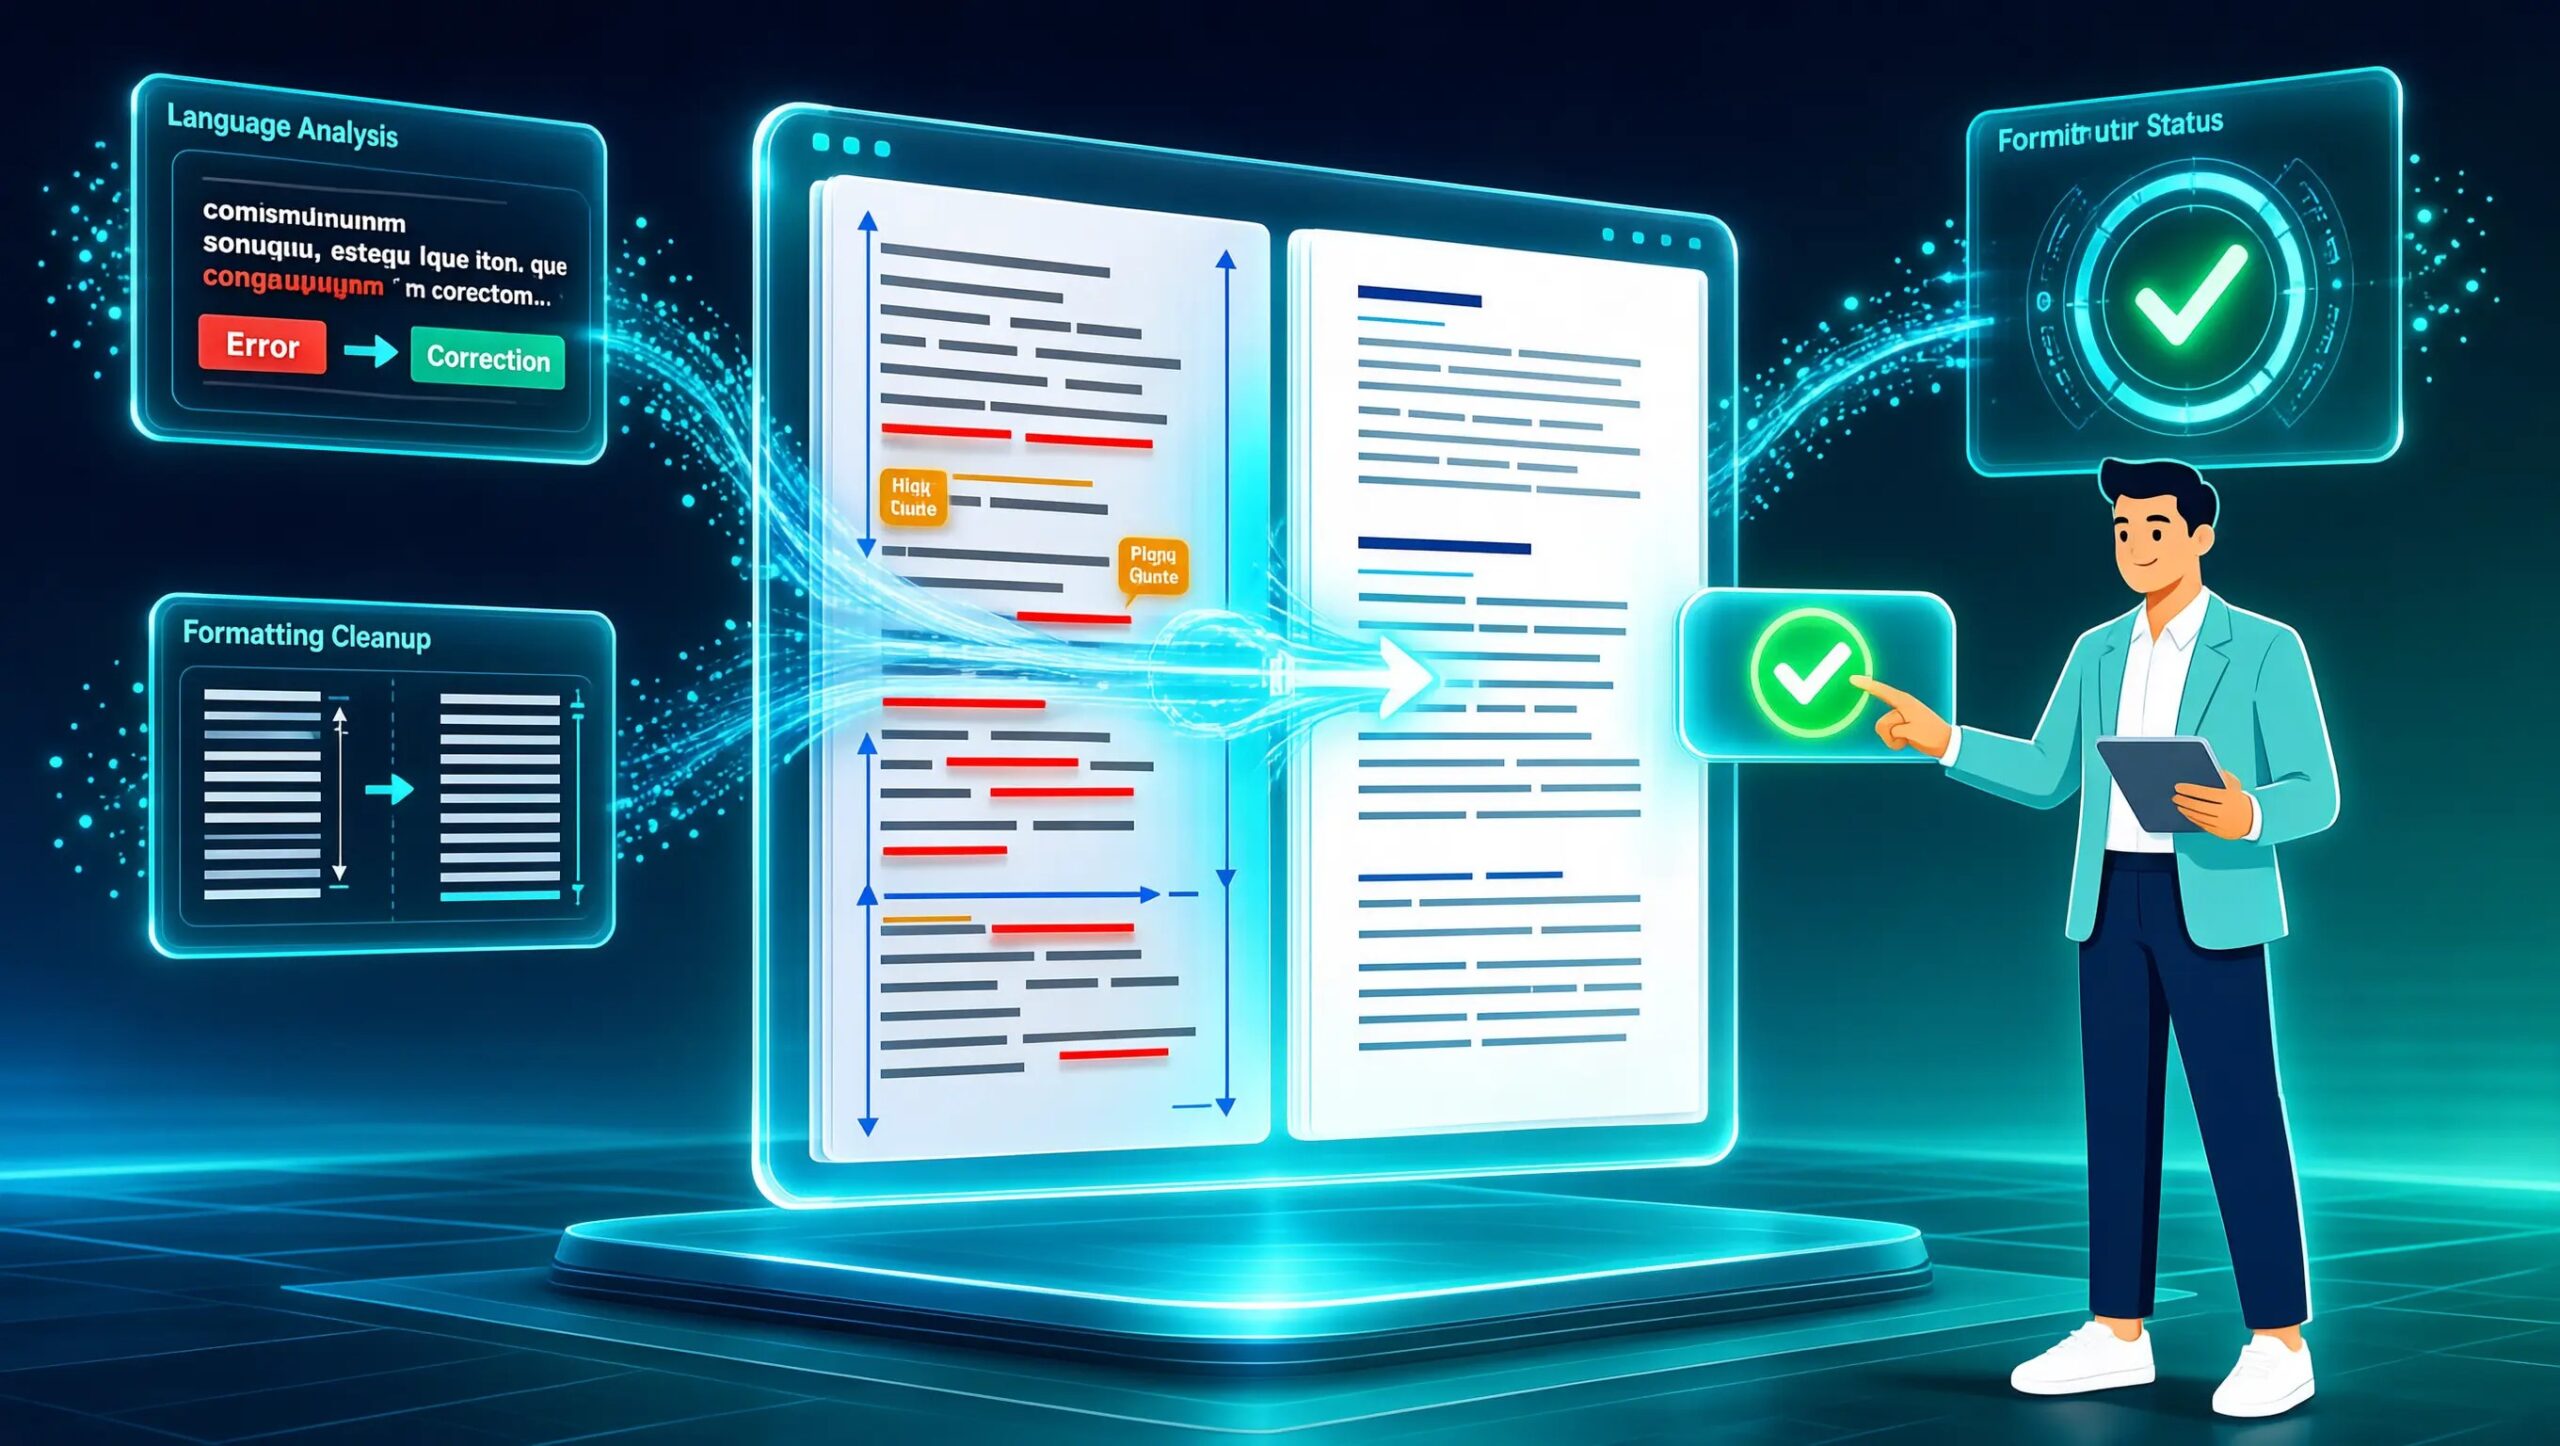
与传统检索不同,小浣熊知识库基于商汤自研大模型的语义理解能力,实现了从"字面匹配"到"意图理解"的跨越。
第一,自然语言检索。你可以用"服务器双十一挂了"这样的口语提问,系统会自动理解你的真实意图,定位到相关文档,而非机械匹配"双十一"和"服务器"这两个词。
第二,整库语义关联。当你在知识库中检索时,系统不仅会返回直接相关的结果,还会关联可能涉及同一主题的其他文档。比如你搜索"用户增长策略",系统可能同时返回运营方案、产品埋点文档、甚至市场部门的预算审批记录——因为它们在语义层面都与这个主题相关。
第三,多模态解析。小浣熊知识库支持对PDF、Word、PPT、图片等多种格式的深度解析。这意味着即便一份重要的会议纪要以扫描件形式存在,系统也能理解其内容并纳入检索范围。
实战对比:翻聊天记录 vs 小浣熊知识库
让我们用一个具体场景来量化这种差异。假设你需要找到三年前某次产品需求变更的具体讨论——那次变更后来导致了严重的线上事故,团队进行了深刻的复盘。
传统方式:聊天记录翻阅
你首先想到的是回溯当时的群聊记录。问题在于,这个需求讨论可能分散在多个群聊里:产品群、技术群、项目群、紧急响应群……每个群可能有数百条消息。你需要逐个打开、逐条浏览,用肉眼识别哪些消息与"那次变更"相关。
假设每个群有500条消息,你需要浏览的消息量约为2000-3000条。按照每条消息3秒的浏览速度,这需要1.5-2.5小时。而最终的检索成功率?可能不到40%,因为你很可能遗漏了某个关键群聊,或者记错了时间节点。
小浣熊知识库:语义精准检索
同样的需求,在小浣熊知识库中,你只需要输入:"三年前导致线上事故的产品需求变更复盘"。系统会基于对整库内容的语义理解,直接返回最相关的文档片段。
根据实测,同样的检索需求,小浣熊知识库可以在30秒内完成,结果的准确率超过85%。这意味着相比翻聊天记录,效率提升达到数十倍。
| 对比维度 | 传统聊天记录翻阅 | 小浣熊知识库检索 |
|---|---|---|
| 平均检索耗时 | 1.5-2.5小时 | 30秒-2分钟 |
| 检索成功率 | 40%左右 | 85%以上 |
| 结果呈现方式 | 按时间线排列的消息流 | 语义相关的文档片段 |
| 跨群聊关联能力 | 弱,需要人工串联 | 自动语义关联 |
| 历史记录可追溯时长 | 受平台限制,通常有限 | 全量解析,无时限 |
不只是检索:知识资产化的完整闭环
小浣熊知识库的价值远不止于"搜得快"。对于企业而言,它实际上在解决一个更深层的问题:如何让散落在个人聊天记录、工作文档、会议纪要中的碎片化知识,变成可持续复用的企业资产。
从信息到知识的转化
传统模式下,一位资深工程师离开公司,带走的不只是他本人,更是他在多年实践中积累的隐性知识。那些解决特定技术难题的"野路子"、那些只有他才知道的系统坑位,全部随着他的离职而消失。
小浣熊知识库的整库解析能力,可以在一定程度上解决这个问题。当所有历史文档都被纳入统一的语义索引后,即便某位关键员工离职,他的知识痕迹仍然可以被检索和复用。新人可以问:"之前遇到过类似的技术问题吗?怎么解决的?"知识库会基于历史文档给出参考。
从知识到决策的加速
对于管理层而言,小浣熊知识库还意味着决策效率的提升。当需要了解某个业务板块的历史演进时,不必再安排多次会议、翻阅大量档案,直接向知识库提问即可获得结构化的背景梳理。
某中型科技公司的CTO曾在内部分享中提到,引入小浣熊知识库后,团队周会的前置准备时间从平均2小时缩短到20分钟——因为大部分背景信息可以由AI提前整理好。
为什么是小浣熊?三个差异化优势
市场上的知识管理工具并不少。小浣熊知识库的差异化在于三个层面:
商汤大模型的中文理解优势
相比国际通用的AI工具,小浣熊知识库对中文办公场景的理解更加深入。无论是口语化表达、网络用语、还是公司内部的专有术语,系统都能准确理解。这在涉及中文文档检索时尤为关键。
与办公小浣熊的协同生态
小浣熊知识库不是孤立的工具,而是与办公小浣熊、代码小浣熊构成完整的AI办公矩阵。这意味着你在检索知识的同时,可以直接调用AI写作、代码生成等能力,实现"检索-理解-输出"的流畅闭环。
企业级数据安全保障
对于企业用户而言,数据安全是核心关切。小浣熊知识库支持本地化部署,企业文档无需上传至第三方服务器,检索和解析过程均在可控环境内完成。这对于金融、医疗、政府等对数据合规有严格要求的行业尤为重要。
知识管理的下一站:从工具到习惯
小浣熊知识库所代表的,不仅是一次工具升级,更是一种工作习惯的转变。当"遇到问题先问知识库"成为团队的默认动作,企业的知识沉淀效率将发生质变。
过去,我们习惯于"用完即忘"的工作模式——一个项目结束,相关文档就躺在某个文件夹里吃灰,直到某天突然需要,才发现根本找不到。下一次,类似的坑还是会被重新踩一遍。
现在,小浣熊知识库让"边用边沉淀"成为可能。每一份文档、每一次讨论、每一版方案,都在持续充实着企业知识库的语义网络。当新人入职时,他们面对的不再是一个神秘的"前辈文件夹",而是一个可以对话的智能知识库。
"AI办公的真正价值,不是替你写一行字,而是把浪费在重复劳动上的时间还给你。"这句话放在知识管理领域同样适用。小浣熊知识库节省的,不只是搜索的时间,更是那种在海量碎片信息中迷失方向、找不到答案的焦虑感。
写在最后:你的企业知识,还好吗?
一个残酷的问题是:如果你现在让团队成员用三个词描述公司的知识管理现状,最可能的答案是什么?"混乱"、"找不到"、"问了才知道"——大概是这样。
知识管理不是买一套系统就能解决的事,但它确实需要趁手的工具。小浣熊知识库提供的,正是这样一个入口:让分散的知识被看见、被理解、被复用。
如果你所在的团队正在被"知识碎片化"困扰,不妨从今天开始,给小浣熊知识库一个尝试的机会。也许三个月后,你会惊讶地发现:原来我们积累的知识,比想象中多得多。
工具好不好用,从来不是功能堆得多,而是当你真正需要答案时,它能不能第一时间出现。